Les centres de données vivent et meurent par un seul chiffre : le temps de disponibilité. Avant de parler de mégawatts, de rendement ou d’architectures d’alimentation, il faut comprendre ce que l’industrie exige réellement de son infrastructure électrique. Le système de classification en Tier de l’Uptime Institute est devenu la référence de fait, allant du Tier 1, qui tolère jusqu’à 28 heures d’arrêt par an, au Tier 4, qui n’autorise que 26 minutes d’indisponibilité annuelles. Le Tier 4, correspondant à une disponibilité de 99,995 %, est typiquement le domaine des installations militaires et des opérations portant sur des données extrêmement sensibles.
Atteindre de tels chiffres n’est pas une affaire de meilleurs convertisseurs. C’est une affaire d’architecture : de la redondance partout, y compris sur le réseau de distribution électrique lui-même, le tout combiné à une gestion de la maintenance, faite de pièces de rechange et de logistique de réparation, car les objectifs de disponibilité sont directement liés au temps moyen de réparation (MTTR). L’arrêt d’un centre de données se mesure en coût par minute, et les engagements de disponibilité sont contractuels. Toute architecture d’alimentation candidate doit démontrer qu’elle survit aux défaillances de composants sans interrompre les charges informatiques.
Dans cet article, je souhaite partager quelques réflexions déclenchées par une étude de fiabilité sur laquelle j’ai récemment travaillé, et soulever ce qui me semble être une question importante pour l’effervescence actuelle autour de l’électrification des fermes de données à l’échelle de l’IA.
L’approche classique
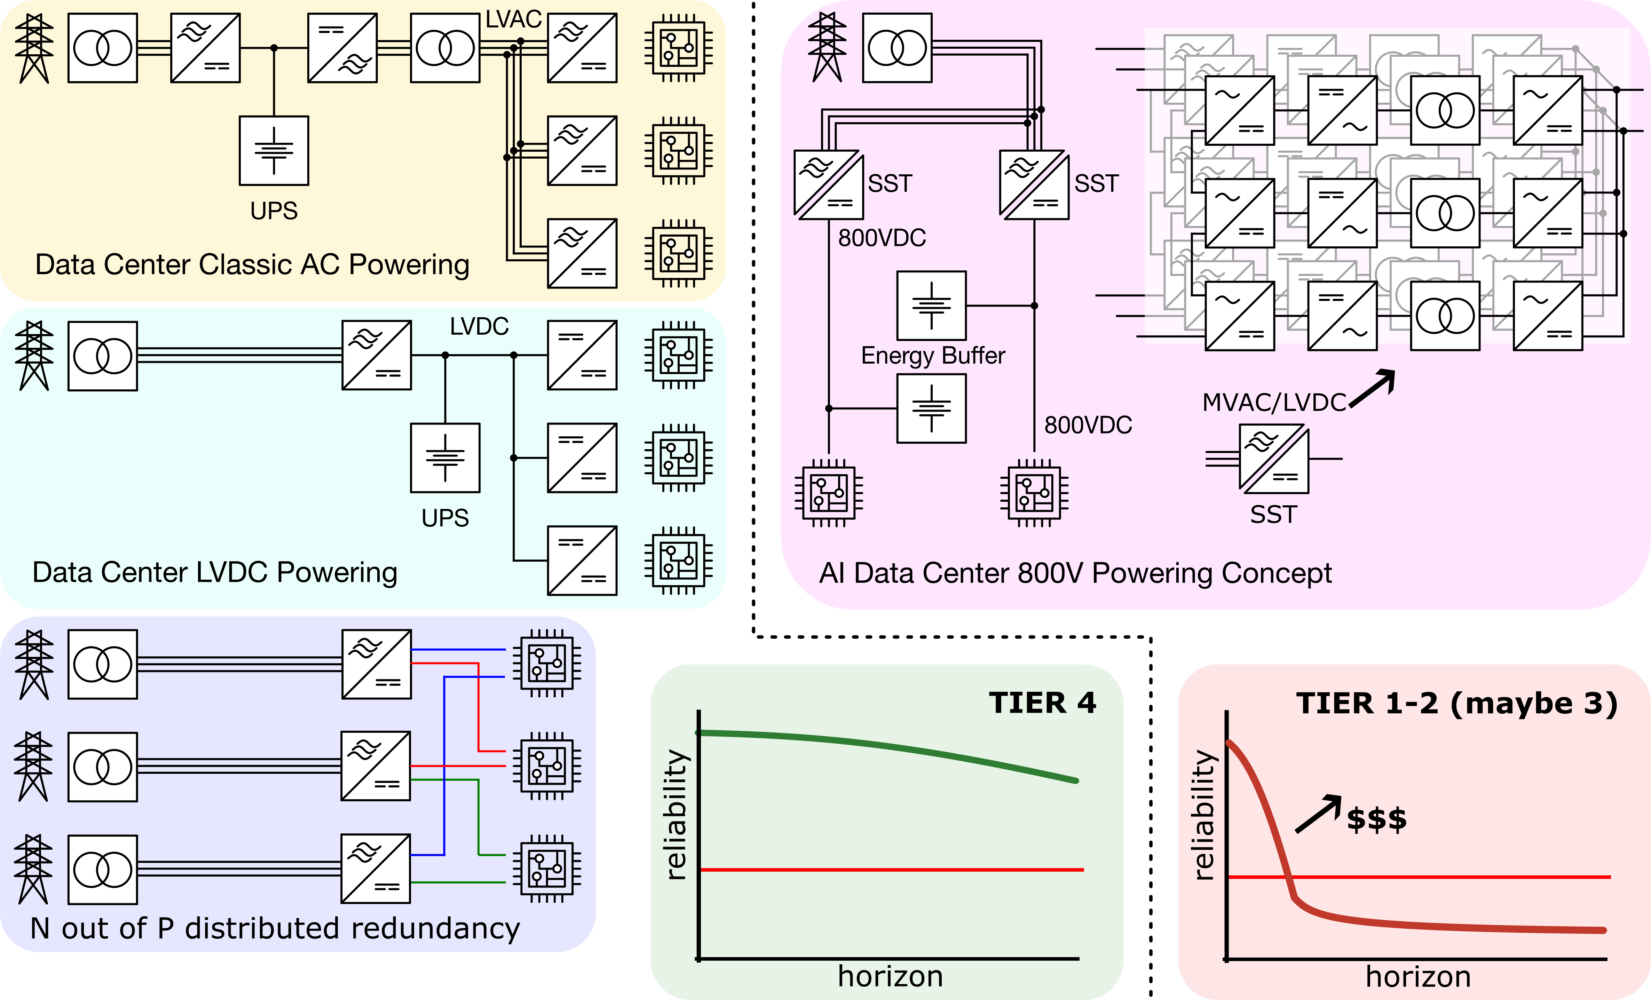
La chaîne d’alimentation en courant alternatif classique d’un centre de données est d’une simplicité presque affligeante. Le courant alternatif moyenne tension arrive du réseau de distribution, un transformateur conventionnel l’abaisse en basse tension, et un onduleur (UPS) est placé en série, reliant les coupures de réseau grâce à sa batterie. En aval, un autre étage de conversion alimente les bus 48 V DC des baies informatiques. L’onduleur effectue une double conversion et les batteries sont raccordées au bus DC intermédiaire par un étage DC-DC supplémentaire. Du point de vue du rendement pur, c’est, disons-le, un peu du gaspillage.
Et pourtant, cela fonctionne, avec une grande fiabilité. Combinée à un schéma de redondance K parmi N, où chaque serveur est alimenté par plusieurs chemins indépendants, l’alimentation AC classique atteint aujourd’hui le Tier 4. La redondance des chemins d’alimentation signifie qu’une défaillance sur une ligne redirige simplement la puissance ; la branche défaillante est réparée pendant que le système continue de fonctionner.
Le LVDC pour un meilleur rendement
Considérons l’architecture suivante : un transformateur MT/BT, un redresseur à diodes créant un bus LVDC (disons entre 400 et 800 V), et l’onduleur fonctionnant en parallèle. En supprimant des étages de conversion, le rendement s’améliore naturellement, remplaçant les volumineuses chaînes de distribution AC. De plus, les serveurs consomment nativement du courant continu : les alimenter depuis un bus LVDC supprime tout un étage AC-DC au niveau de la baie.
Le gain est mesurable. Moins d’étages de conversion signifie moins de pertes, moins de refroidissement, une empreinte plus réduite. Par ailleurs, avec une redondance adéquate des convertisseurs DC, l’argument de fiabilité semble tenir : dupliquez les convertisseurs, et la probabilité de perdre tous les chemins d’alimentation devient infime.
Jusqu’ici, tout va bien…
Les promesses de la transformation à semi-conducteurs (les SSTs)
Voici l’aspect qui, à mon sens, n’est pas assez discuté dans la communauté : dès l’instant où l’on introduit des convertisseurs à semi-conducteurs sur la moyenne tension, le calcul de la fiabilité change fondamentalement.
Un transformateur à semi-conducteurs (ou devrais-je dire un convertisseur électronique de puissance – voir mon article précédent) est, par construction, une cascade de cellules d’électronique de puissance composées de semi-conducteurs, de drivers, de contrôleurs, de capteurs et de refroidissement, le tout connecté en structures série en entrée et parallèle en sortie pour tenir la moyenne tension et l’exigence en puissance des charges informatiques (jusqu’à 5MW). Chaque cellule individuelle multiplie le nombre de composants, et chaque composant supplémentaire est une occasion de défaillance supplémentaire. Une chaîne d’alimentation basée sur un SST présente un nombre de composants par mégawatt qu’aucun transformateur passif n’a jamais eu.
Pour un SST connecté à la moyenne tension, la prédiction du taux de défaillance s’accumule sur le transformateur moyenne fréquence, l’étage de puissance, l’électronique de contrôle, les systèmes auxiliaires et le refroidissement. La disponibilité résultante de la chaîne de conversion ne correspond pas, loin s’en faut, aux attentes brutes de disponibilité que l’on dériverait de la fiabilité des infrastructures électriques classiques. Cet écart relève de l’architecture, non de la technologie des composants. Une atténuation est possible avec un travail d’ingénierie système : en distribuant la redondance de sorte qu’aucun point de défaillance unique n’existe, et en planifiant une maintenance préventive fréquente pour remplacer les modules défaillants avant que la redondance ne soit épuisée, on peut restaurer un niveau de disponibilité comparable aux solutions classiques.
Posons maintenant la question suivante : pourquoi les exploitants de centres de données passeraient-ils d’une solution à transformateur hautement fiable à un convertisseur comptant tellement de composants qu’il s’accompagne de campagnes de maintenance mensuelles, de taux de défaillance soutenus, d’une gestion étendue des pièces de rechange et d’une part substantielle du budget matériel dédiée uniquement à la redondance, aux contacteurs et à la détection de routage, tout cela pour atteindre un niveau de Tier que l’alimentation AC classique atteint naturellement ?
La question qui bloque tout
Je tiens à être clair : il ne s’agit pas d’un rejet de la transformation à semi-conducteurs pour les architectures DC. Ce que je conteste, c’est le bilan au niveau système. L’ingénierie de fiabilité enseigne la chose suivante : chaque composant ajouté est un nouveau mode de défaillance, et aucune redondance ne compense pleinement si le taux de défaillance sous-jacent est trop élevé. Entre la fiabilité intrinsèque des étages de conversion à semi-conducteurs et la charge opérationnelle qu’imposent les interventions préventives fréquentes se trouve un point d’équilibre. Entre la promesse et le déploiement se dresse une question qu’aucun article, à ma connaissance, n’aborde honnêtement :
Qui paie pour la disponibilité ?
La chaîne classique à transformateurs y parvient presque gratuitement, architecturalement parlant. La chaîne à semi-conducteurs paie en cadence de maintenance, en redondance de modules et, en fin de compte, en acceptation opérationnelle. Tant que cette équation n’est pas résolue, que ce soit par la redondance architecturale, la simplification intrinsèque des topologies ou la maintenance prédictive réduisant le MTTR, le modèle économique reste fragile, précisément au moment où les hyperscalers poussent le plus fort vers des fermes DC à l’échelle de l’IA.
Il n’y a pas de réponse définitive à l’heure actuelle, mais je pense que cette question mérite d’être posée maintenant, à voix haute, plutôt que découverte comme une limite après la mise en service de la première génération de centres de données alimentés par des SST. La transformation à semi-conducteurs apporte rendement et flexibilité aux centres de données alimentés en courant continu, mais son budget de fiabilité, couplé à l’intensité de maintenance nécessaire pour atteindre des disponibilités de Tier supérieur, demeure une préoccupation structurelle. Ce n’est pas un détail d’ingénierie ; c’est une contrainte conditionnante pour le déploiement.